3. RKNN Toolkit2介绍
RKNN Toolkit2 开发套件(Python接口)运行在PC平台(x86/arm64),提供了模型转换、 量化功能、模型推理、性能和内存评估、量化精度分析、模型加密等功能。 更详细的功能说明参考下RKNN-Toolkit2工程文件的 《RKNN-Toolkit2用户使用指南》 。
本章将简单介绍在PC(Ubuntu系统)上使用RKNN-Toolkit2进行模型转换、模型推理、性能评估等测试。
重要
测试环境:鲁班猫RK系列板卡,镜像系统是Debian或者ubuntu,PC环境使用ubuntu20.04(WSL2),教程编写时的RKNN-Toolkit2是2.3.2版本
3.1. Toolkit2安装
安装Toolkit2,可以使用Python的包管理器pip3安装,或者直接使用docker构建Toolkit2环境。
相关依赖库和docker文件从瑞芯微官方 RKNN-Toolkit2工程
或者从 云盘资料下载 (提取码hslu),
在 1-野火开源图书_教程文档\配套代码->嵌入式AI应用开发实战指南->AI教程相关源文件->rknn-toolkit2
(获取的RKNN-Toolkit2文件中包含RKNN Toolkit Lite2)。
虽然Toolkit2最新版本支持arm64,但考虑到性能和兼容性,教程测试模型转换等等都是在x86平台上。 使用conda管理Toolkit2环境,参考前面 开发环境章节 安装toolkit2。
3.2. RKNN Toolkit2接口使用
本节熟悉下Toolkit2工具,该工具在PC平台上使用,提供Python接口简化模型的部署和运行。 用户通过该工具可以便捷地完成一些功能:
模型转换,Toolkit2工具导入原始的Caffe、TensorFlow、TensorFlow Lite、ONNX、Pytorch、MXNet等模型转换成RKNN模型(), 也支持导入RKNN模型然后在NPU平台 上加载推理等。
量化功能,支持将浮点模型量化为定点模型,目前支持的量化方法为非对称量化(asymmetric_quantized-8),并支持混合量化功能。
模型推理,能够在PC上模拟NPU运行RKNN模型并获取推理结果;或将RKNN模型分发到指定的NPU设备上进行推理并获取推理结果。
性能和内存评估,连接板卡,将RKNN模型分发到指定NPU设备上运行,然后评估模型在实际设备上运行时的性能和内存占用情况。
量化精度分析,该功能将给出模型量化后每一层推理结果与浮点模型推理结果的余弦距离,以分析量化误差是如何出现的,为提高量化模型的精度提供思路。
模型加密功能,使用指定的加密等级将RKNN模型整体加密,因为RKNN模型的解密是在NPU驱动中完成的,所以使用加密模型时,与普通RKNN模型一样加载即可,NPU驱动会自动对其进行解密。
使用Toolkit2,可以运行在PC上,通过模拟器运行模型,然后进行推理,或者模型转换等操作;也可以运行在连接的板卡NPU上, 将RKNN模型传到NPU设备上运行,再从NPU设备上获取推理结果、性能信息等等。
Toolkit2运行模型时的一个简单的流程示意:
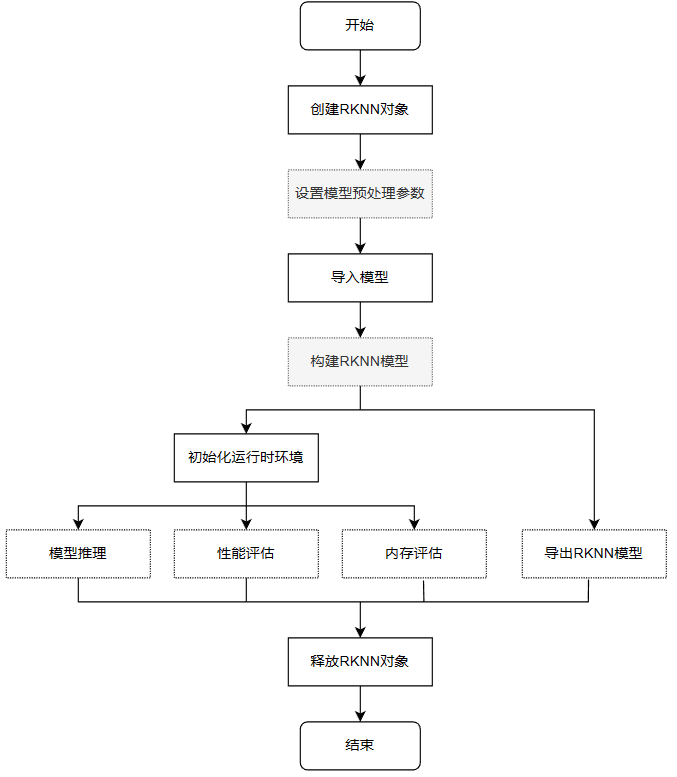
流程简单描述:
创建RKNN对象,初始化RKNN环境
设置模型预处理参数,如果是运行在PC上,通过模拟器运行模型时需要调用config接口设置模型的预处理参数;如果运行在连接的板卡NPU上并且导入RKNN模型,不需要配置。
导入模型,如果是运行在PC上,通过模拟器运行模型时使用load_caffe、load_tensorflow等接口导入对应的非RKNN模型,通过;如果运行在连接的板卡NPU使用接口load_rknn导入RKNN模型。
构建RKNN模型,如果是运行在PC上,通过模拟器运行模型,需要调用build接口构建RKNN模型,然后可以导出RKNN模型或者初始化运行环境进行推理等操作;如果运行在连接的板卡NPU上不需要。
初始化运行时环境,如果需要模型推理或性能评估,必须先调用init_runtime初始化运行时环境,要指定模型的运行平台(模拟器或者连接板卡的硬件NPU)。
初始化运行环境后,可以调用inference接口进行推理,使用eval_perf接口对模型性能进行评估,或者使用eval_memory接口获取模型在硬件平台上运行时的内存使用情况(模型必须运行在硬件平台上)。
最后调用release接口释放RKNN对象。
使用load_rknn导入rknn模型时,不能调用accuracy_analysis精度分析,需要导入非rknn模型,然后构建模型时设置量化。
详细的接口说明参考下 RKNN Toolkit2 工程中doc/目录下的用户手册,详细使用例程请参考RKNN-Toolkit2工程中examples/functions目录下例程。
3.2.1. 模型转换和量化以及模拟推理
这小节展示下在PC上使用Toolkit2工具进行模型的转换、量化和模拟器推理(以yolov5为例)。
测试例程可以 教程配套例程 , 或者从 RKNN-Toolkit2工程 文件中example目录下的onnx/yolov5中获取。
在已经搭建好RKNN-Toolkit2的运行环境中,执行下面命令,程序将加载onnx模型,然后量化导出rknn模型,最后测试模型。
# 切换到配套例程rknn-toolkit2/yolov5目录下(测试使用教程配套例程)
(toolkit2_2.3.2) llh@YH-LONG:~$ cd lubancat_ai_manual_code/dev_env/rknn-toolkit2/yolov5
# 运行test.py,模型转换和模型推理
(toolkit2_2.3.2) llh@YH-LONG:~/XXXX/yolov5$ python3 test.py
I rknn-toolkit2 version: 2.3.2
--> Config model
done
--> Loading model
I Loading : 100%|██████████████████████████████████████████████| 123/123 [00:00<00:00, 17879.65it/s]
done
--> Building model
D base_optimize ...
D base_optimize done.
# 省略.....................................
I rknn building done.
done
--> Export rknn model
done
--> Init runtime environment
I Target is None, use simulator!
done
--> Running model
I GraphPreparing : 100%|███████████████████████████████████████| 153/153 [00:00<00:00, 11162.05it/s]
I SessionPreparing : 100%|██████████████████████████████████████| 153/153 [00:00<00:00, 2216.00it/s]
done
class        score      xmin, ymin, xmax, ymax
--------------------------------------------------
person       0.884     [ 208,  244,  286,  506]
person       0.868     [ 478,  236,  559,  528]
person       0.825     [ 110,  238,  230,  533]
person       0.334     [  79,  353,  122,  517]
    bus         0.705     [  92,  128,  554,  467]
Save results to result.jpg!
在test.py主程序中:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 | if __name__ == '__main__':
# 创建RKNN对象(默认开启了debug)
rknn = RKNN(verbose=True)
# 设置模型转换参数,这里可以指定平台,添加target_platform='rk3588'配置,默认rk3566
# mean_values是设置输入的均值,std_values是输入的归一化值
print('--> Config model')
rknn.config(mean_values=[[0, 0, 0]], std_values=[[255, 255, 255]], target_platform='rk3566')
print('done')
# 导入onnx模型,使用model指定onnx模型路径
print('--> Loading model')
ret = rknn.load_onnx(model=ONNX_MODEL)
if ret != 0:
print('Load model failed!')
exit(ret)
print('done')
# 构建RKNN模型,这里设置do_quantization为true开启量化,dataset是指定用于量化校正的数据集
print('--> Building model')
ret = rknn.build(do_quantization=QUANTIZE_ON, dataset=DATASET)
if ret != 0:
print('Build model failed!')
exit(ret)
print('done')
# 导出RKNN模型,使用export_path指定导出模型路径,这里默认设置RKNN_MODEL
print('--> Export rknn model')
ret = rknn.export_rknn(RKNN_MODEL)
if ret != 0:
print('Export rknn model failed!')
exit(ret)
print('done')
# 调用init_runtime接口初始化运行时环境,默认是在PC上模拟仿真
print('--> Init runtime environment')
ret = rknn.init_runtime()
#ret = rknn.init_runtime('rk3566')
if ret != 0:
print('Init runtime environment failed!')
exit(ret)
print('done')
# 设置输出,用于模型推理
img = cv2.imread(IMG_PATH)
# img, ratio, (dw, dh) = letterbox(img, new_shape=(IMG_SIZE, IMG_SIZE))
img = cv2.cvtColor(img, cv2.COLOR_BGR2RGB)
img = cv2.resize(img, (IMG_SIZE, IMG_SIZE))
# 进行推理,没有设置init_runtime目标默认使用模拟器,之后对输出数据后处理并保存结果
print('--> Running model')
outputs = rknn.inference(inputs=[img])
np.save('./onnx_yolov5_0.npy', outputs[0])
np.save('./onnx_yolov5_1.npy', outputs[1])
np.save('./onnx_yolov5_2.npy', outputs[2])
print('done')
# 省略...
|
该例程将配置并导入onnx模型(yolov5s_relu.onnx),测试板卡不同时,需要自行修改例程test.py中的target_platform:
# target_platform:指定RKNN模型是基于哪个目标芯片平台生成的。目前支持“rv1103”、
#“rv1103b”、“rv1106”、“rv1106b”、“rv1126b”、“rk2118”、“rk3562”、“rk3566”、“rk3568”、
#“rk3576”和“rk3588”,该参数对大小写不敏感,默认值为None。

# 设置模型转换参数,指定平台,如果是lubancat-4/5就添加target_platform='rk3588'配置
# 如果是lubancat-0/1就设置rk3566,lubancat-2设置rk3568,lubancat-3就设置rk3576等


# mean_values是设置输入的均值,std_values是输入的归一化值
print('--> Config model')
rknn.config(mean_values=[[0, 0, 0]], std_values=[[255, 255, 255]], target_platform='rk3588')
print('done')
然后是构建RKNN模型,可以设置模型量化参数和量化数据集,RKNN支持三种量化算法(norm/mmse/kl)及两种量化粒度(layer/channel), 根据需求的精度与速度权衡选择,只需要注意设置量化算法是在前面的rknn.config参数中。
print('--> Building model')
ret = rknn.build(do_quantization=QUANTIZE_ON, dataset=DATASET)
if ret != 0:
对模型进行量化之后导出RKNN模型(yolov5s_relu.rknn)。 之后初始化运行环境(init_runtime),使用模拟器模拟推理获取输出数据,对输出数据后处理,最终得到结果图片(result.jpg)。
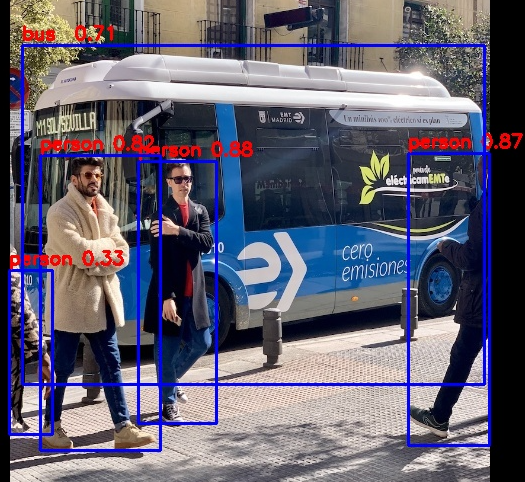
例程运行默认开启了debug,将会打印模型的网络层信息表、特征张量信息表、常量张量信息表以及权重和参数的内存使用等信息。
3.2.2. 性能和内存评估
本小节将使用 RKNN Toolkit2 的调试等功能,进行性能和内存评估或者推理等操作。
RKNN Toolkit2运行在PC上(x86),通过PC的USB连接NPU设备, RKNN Toolkit2将RKNN模型传到NPU设备上运行,再从NPU设备上获取推理结果、性能信息等。
在开始例程前我们需要确认adb连接(选择网络adb或者usb adb方式):
1.1、通过网络连接板卡,这里测试实际通过网络adb连接板卡。在板卡上先启动adbd(可以从配套例程获取):
# 在板卡上执行命令:
cat@lubancat:~$ ./adbd &
[1] 41260
cat@lubancat:~$ install_listener('tcp:5037','*smartsocket*')
using port=5555
在PC Ubuntu20.04上安装adb,直接使用命令 sudo apt install -y adb ,安装成功后使用adb devices命令启动adb server,
在板卡上我们启动adbd。然后板子和PC连接在一个局域网下(可以互相ping通),使用下面命令:
# PC端安装adb
(toolkit2_2.3.2) llh@YH-LONG:~$ sudo apt install -y adb

# 开启adb server
(toolkit2_2.3.2) llh@YH-LONG:~$ adb start-server

# 连接板子,IP根据具体板子,默认5555端口
(toolkit2_2.3.2) llh@YH-LONG:~$ adb connect 192.168.103.131:5555
already connected to 192.168.103.131:5555

# 查看连接的设备,连接成功,这就是RKNN初始化运行时的device_id
(toolkit2_2.3.2) llh@YH-LONG:~$ adb devices
List of devices attached
192.168.103.131:5555    device
1.2、通过usb连接,首先通过 usb gadget 将otg口配置成adb调试,然后用type-c线将板卡和电脑连接(使用虚拟机时要注意连接到虚拟机上),最后使用以下命令查看id。
#获取id,此时id为cee99073e6f57988
(toolkit2_2.3.2) llh@YH-LONG:~$ adb devices
List of devices attached
* daemon not running; starting now at tcp:5037
* daemon started successfully
cee99073e6f57988       device
2、板卡上启动rknn_server服务,该服务是一个运行在板子上的后台代理服务,用于接收PC通过USB传输过来的协议, 然后执行板端runtime对应的接口,并返回结果给PC,该rknn_server文件,鲁班猫板卡系统固件默认 已经添加(可以从 RKNPU2工程 文件获取更新)。
在linux平台上,我们需要添加librknnrt.so(鲁班猫板卡系统默认已经有,可以更新下), 该文件从 RKNPU2 的runtime/XXXX/Linux/rknn_server目录下获取,或者教程配套例程中获取。
# 在板卡上执行restart_rknn.sh或者直接执行rknn_server
# 如果想查看运行日志,可以设置环境变量export RKNN_LOG_LEVEL=4
cat@lubancat:~$ rknn_server
start rknn server, version:1.5.0 (17e11b1 build: 2023-05-18 21:43:39)
I NPUTransfer: Starting NPU Transfer Server, Transfer version 2.1.0 (b5861e7@2020-11-23T11:50:51)
接下来获取配套例程,然后测试例程(测试使用RKNN模型,使用前面小节导出的rknn模型):
(toolkit2_2.3.2) llh@YH-LONG:~$ cd lubancat_ai_manual_code/dev_env/rknn-toolkit2/yolov5
(toolkit2_2.3.2) llh@YH-LONG:~/rknn-toolkit2/examples/evaluation/yolov5$ python3 evaluation.py
I rknn-toolkit2 version: 2.3.2
--> Loading model
done
--> Init runtime environment
adb: unable to connect for root: closed
I target set by user is: rk3588
I Get hardware info: target_platform = rk3588, os = Linux, aarch = aarch64
I Check RK3588 board npu runtime version
I Starting ntp or adb, target is RK3588
I Start adb...
I Connect to Device success!
I Flag perf_debug has been set, it will affect the performance of inference!
I Flag eval_mem has been set, it will affect the performance of inference!
I NPUTransfer(8886): Starting NPU Transfer Client, Transfer version 2.2.2 (12abf2a@2024-09-02T03:22:41)
I NPUTransfer(8886): TransferBuffer: min aligned size: 1024
D RKNNAPI: ==============================================
D RKNNAPI: RKNN VERSION:
D RKNNAPI:   API: 2.3.2 (1842325 build@2025-03-30T09:55:23)
D RKNNAPI:   DRV: rknn_server: 1.5.0 (17e11b1 build: 2023-05-18 21:43:39)
D RKNNAPI:   DRV: rknnrt: 2.3.2 (429f97ae6b@2025-04-09T09:09:27)
D RKNNAPI: ==============================================
D RKNNAPI: Input tensors:
D RKNNAPI:   index=0, name=images, n_dims=4, dims=[1, 640, 640, 3], n_elems=1228800, size=1228800, w_stride = 0, size_with_stride = 0, fmt=NHWC, type=INT8, qnt_type=AFFINE, zp=-128, scale=0.003922
D RKNNAPI: Output tensors:
D RKNNAPI:   index=0, name=output, n_dims=4, dims=[1, 255, 80, 80], n_elems=1632000, size=1632000, w_stride = 0, size_with_stride = 0, fmt=NCHW, type=INT8, qnt_type=AFFINE, zp=-128, scale=0.003860
D RKNNAPI:   index=1, name=283, n_dims=4, dims=[1, 255, 40, 40], n_elems=408000, size=408000, w_stride = 0, size_with_stride = 0, fmt=NCHW, type=INT8, qnt_type=AFFINE, zp=-128, scale=0.003922
D RKNNAPI:   index=2, name=285, n_dims=4, dims=[1, 255, 20, 20], n_elems=102000, size=102000, w_stride = 0, size_with_stride = 0, fmt=NCHW, type=INT8, qnt_type=AFFINE, zp=-128, scale=0.003915
done
--> eval_perf
CPU Current Frequency List:
    - 1800000
    - 2256000
    - 2256000
NPU Current Frequency List:
    - 1000000000
DDR Current Frequency List:
    - 1848000000

Warning: The performance result is just for debugging, may worse than actual performance!
------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------
                                                                        Network Layer Information Table
------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------
ID   OpType             DataType Target InputShape                               OutputShape            Cycles(DDR/NPU/Total)    Time(us)     MacUsage(%)          WorkLoad(0/1/2)      RW(KB)       FullName
------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------
1    InputOperator      UINT8    CPU    \                                        (1,3,640,640)          0/0/0                    9                                 0.0%/0.0%/0.0%       0            InputOperator:images
2    Conv               UINT8    NPU    (1,3,640,640),(12,3,2,2),(12)            (1,12,320,320)         138575/409600/409600     693          2.08/0.00/0.00       100.0%/0.0%/0.0%     1201         Conv:Conv_0
3    ConvRelu           INT8     NPU    (1,12,320,320),(32,12,3,3),(32)          (1,32,320,320)         237708/921600/921600     1058         32.67/0.00/0.00      100.0%/0.0%/0.0%     1604         Conv:Conv_1
4    ConvRelu           INT8     NPU    (1,32,320,320),(64,32,3,3),(64)          (1,64,160,160)         238388/460800/460800     729          63.21/0.00/0.00      100.0%/0.0%/0.0%     3218         Conv:Conv_3
5    ConvRelu           INT8     NPU    (1,64,160,160),(32,64,1,1),(32)          (1,32,160,160)         118848/102400/118848     276          18.55/0.00/0.00      100.0%/0.0%/0.0%     1602         Conv:Conv_5
# 省略...........................................................................................................................
80   ConvRelu           INT8     NPU    (1,512,20,20),(256,512,1,1),(256)        (1,256,20,20)          21274/51200/51200        92           55.65/0.00/0.00      100.0%/0.0%/0.0%     330          Conv:Conv_140
81   ConvRelu           INT8     NPU    (1,256,20,20),(256,256,1,1),(256)        (1,256,20,20)          13160/25600/25600        59           43.39/0.00/0.00      100.0%/0.0%/0.0%     166          Conv:Conv_136
82   ConvRelu           INT8     NPU    (1,256,20,20),(256,256,3,3),(256)        (1,256,20,20)          38491/230400/230400      265          86.94/0.00/0.00      100.0%/0.0%/0.0%     678          Conv:Conv_138
83   Concat             INT8     NPU    (1,256,20,20),(1,256,20,20)              (1,512,20,20)          0/0/0                    59                                100.0%/0.0%/0.0%     200          Concat:Concat_142
84   ConvRelu           INT8     NPU    (1,512,20,20),(512,512,1,1),(512)        (1,512,20,20)          32653/102400/102400      142          72.11/0.00/0.00      100.0%/0.0%/0.0%     460          Conv:Conv_143
85   ConvSigmoid        INT8     NPU    (1,512,20,20),(255,512,1,1),(255)        (1,255,20,20)          21274/51200/51200        101          50.50/0.00/0.00      100.0%/0.0%/0.0%     330          Conv:Conv_149
86   OutputOperator     INT8     CPU    (1,255,20,20)                            \                      0/0/0                    10                                0.0%/0.0%/0.0%       100          OutputOperator:285
------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------
Total Operator Elapsed Per Frame Time(us): 17003
Total Memory Read/Write Per Frame Size(KB): 56429.78
------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------
---------------------------------------------------------------------------------------------------
                                Operator Time Consuming Ranking Table
---------------------------------------------------------------------------------------------------
OpType             CallNumber   CPUTime(us)  GPUTime(us)  NPUTime(us)  TotalTime(us)  TimeRatio(%)
---------------------------------------------------------------------------------------------------
ConvRelu           50           0            0            10943        10943          64.36%
ConvReluAdd        7            0            0            1914         1914           11.26%
Concat             13           0            0            1608         1608           9.46%
ConvSigmoid        3            0            0            1254         1254           7.38%
Conv               1            0            0            693          693            4.08%
MaxPool            6            0            0            286          286            1.68%
Resize             2            0            0            191          191            1.12%
OutputOperator     3            105          0            0            105            0.62%
InputOperator      1            9            0            0            9              0.05%
---------------------------------------------------------------------------------------------------
Total                           114          0            16889        17003
---------------------------------------------------------------------------------------------------

done
--> eval_memory
======================================================
            Memory Profile Info Dump
======================================================
NPU model memory detail(bytes):
    Weight Memory: 6.96 MiB
    Internal Tensor Memory: 7.42 MiB
    Other Memory: 928.12 KiB
    Total Memory: 15.29 MiB

INFO: When evaluating memory usage, we need consider
the size of model, current model size is: 7.99 MiB
======================================================

done
test.py主程序:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 | if __name__ == '__main__':
# 创建RKNN
# 如果测试遇到问题,请开启verbose=True,查看调试信息。
#rknn = RKNN(verbose=True)
rknn = RKNN()
# 导入RKNN模型,path参数指定rknn模型路径
print('--> Loading model')
ret = rknn.load_rknn(path=RKNN_MODEL)
if ret != 0:
print('Load model failed!')
exit(ret)
print('done')
# 初始化运行时环境,指定连接的板卡NPU平台,device_id指定前面adb连接的板卡设备ID
# perf_debug开启进行性能评估时开启debug模式,eval_mem进入内存评估模式
print('--> Init runtime environment')
ret = rknn.init_runtime(target='rk3588', device_id='192.168.103.131:5555', perf_debug=True, eval_mem=True)
if ret != 0:
print('Init runtime environment failed!')
exit(ret)
print('done')
# 模型性能进行评估,默认is_print是true,打印内存使用情况
print('--> eval_perf')
rknn.eval_perf()
print('done')
# 调试,模型性能进行评估,默认is_print是true,打印内存使用情况
print('--> eval_memory')
rknn.eval_memory()
print('done')
rknn.release()
|
3.2.3. 量化精度分析
toolkit2支持提供接口accuracy_analysis,该接口的功能是进行浮点、量化推理并产生每层的数据,并进行量化精度分析。 开始下面测试前请按前面小节连接adb设备。
(toolkit2_2.3.2) llh@YH-LONG:~$ cd lubancat_ai_manual_code/dev_env/rknn-toolkit2/yolov5
(toolkit2_2.3.2) llh@YH-LONG:~/rknn-toolkit2/examples/evaluation/yolov5$ python accuracy_analysis.py
I rknn-toolkit2 version: 2.3.2
--> Config model
done
--> Loading model
I Loading : 100%|██████████████████████████████████████████████| 123/123 [00:00<00:00, 13579.16it/s]
done
--> Building model
I OpFusing 0: 100%|█████████████████████████████████████████████| 100/100 [00:00<00:00, 4774.88it/s]
I OpFusing 1 : 100%|████████████████████████████████████████████| 100/100 [00:00<00:00, 2642.93it/s]
I OpFusing 2 : 100%|████████████████████████████████████████████| 100/100 [00:00<00:00, 2379.56it/s]
I GraphPreparing : 100%|███████████████████████████████████████| 149/149 [00:00<00:00, 13974.76it/s]
I Quantizating : 100%|███████████████████████████████████████████| 149/149 [00:00<00:00, 455.92it/s]
W build: The default input dtype of 'images' is changed from 'float32' to 'int8' in rknn model for performance!
                    Please take care of this change when deploy rknn model with Runtime API!
W build: The default output dtype of 'output' is changed from 'float32' to 'int8' in rknn model for performance!
                    Please take care of this change when deploy rknn model with Runtime API!
W build: The default output dtype of '283' is changed from 'float32' to 'int8' in rknn model for performance!
                    Please take care of this change when deploy rknn model with Runtime API!
W build: The default output dtype of '285' is changed from 'float32' to 'int8' in rknn model for performance!
                    Please take care of this change when deploy rknn model with Runtime API!
I rknn building ...
I rknn building done.
done
--> Accuracy analysis
adb: unable to connect for root: closed
I target set by user is: rk3588
I Get hardware info: target_platform = rk3588, os = Linux, aarch = aarch64
I Check RK3588 board npu runtime version
I Starting ntp or adb, target is RK3588
I Start adb...
I Connect to Device success!
I NPUTransfer(12381): Starting NPU Transfer Client, Transfer version 2.2.2 (12abf2a@2024-09-02T03:22:41)
I NPUTransfer(12381): TransferBuffer: min aligned size: 1024
D RKNNAPI: ==============================================
D RKNNAPI: RKNN VERSION:
D RKNNAPI:   API: 2.3.2 (1842325 build@2025-03-30T09:55:23)
D RKNNAPI:   DRV: rknn_server: 1.5.0 (17e11b1 build: 2023-05-18 21:43:39)
D RKNNAPI:   DRV: rknnrt: 2.3.2 (429f97ae6b@2025-04-09T09:09:27)
D RKNNAPI: ==============================================
D RKNNAPI: Input tensors:
D RKNNAPI:   index=0, name=images, n_dims=4, dims=[1, 640, 640, 3], n_elems=1228800, size=1228800, w_stride = 0, size_with_stride = 0, fmt=NHWC, type=INT8, qnt_type=AFFINE, zp=-128, scale=0.003922
D RKNNAPI: Output tensors:
D RKNNAPI:   index=0, name=output, n_dims=4, dims=[1, 255, 80, 80], n_elems=1632000, size=1632000, w_stride = 0, size_with_stride = 0, fmt=NCHW, type=INT8, qnt_type=AFFINE, zp=-128, scale=0.003860
D RKNNAPI:   index=1, name=283, n_dims=4, dims=[1, 255, 40, 40], n_elems=408000, size=408000, w_stride = 0, size_with_stride = 0, fmt=NCHW, type=INT8, qnt_type=AFFINE, zp=-128, scale=0.003922
D RKNNAPI:   index=2, name=285, n_dims=4, dims=[1, 255, 20, 20], n_elems=102000, size=102000, w_stride = 0, size_with_stride = 0, fmt=NCHW, type=INT8, qnt_type=AFFINE, zp=-128, scale=0.003915
adb: unable to connect for root: closed
/userdata/dumps/: 86 files pulled. 4.2 MB/s (158864640 bytes in 36.014s)
I Save Tensors to txt: 100%|████████████████████████████████████████| 85/85 [00:04<00:00, 19.05it/s]
I GraphPreparing : 100%|███████████████████████████████████████| 153/153 [00:00<00:00, 23101.21it/s]
I AccuracyAnalysing : 100%|███████████████████████████████████████| 153/153 [00:19<00:00,  7.78it/s]

# simulator_error: calculate the output error of each layer of the simulator (compared to the 'golden' value).
#              entire: output error of each layer between 'golden' and 'simulator', these errors will accumulate layer by layer.
#              single: single-layer output error between 'golden' and 'simulator', can better reflect the single-layer accuracy of the simulator.
# runtime_error: calculate the output error of each layer of the runtime.
#              entire: output error of each layer between 'golden' and 'runtime', these errors will accumulate layer by layer.
#              single_sim: single-layer output error between 'simulator' and 'runtime', can better reflect the single-layer accuracy of runtime.

layer_name                               simulator_error                             runtime_error
                                    entire              single                  entire           single_sim
                                cos      euc        cos      euc            cos      euc        cos      euc
----------------------------------------------------------------------------------------------------------------
[Input] images                  1.00000 | 0.0       1.00000 | 0.0
[exDataConvert] images_int8     1.00000 | 2.5780    1.00000 | 2.5780
[Conv] 128                      1.00000 | 2.5780    1.00000 | 2.5780        1.00000 | 2.5780    1.00000 | 0.0
[Conv] 286
[Relu] 131                      0.99984 | 37.674    0.99984 | 37.674        0.99984 | 37.682    1.00000 | 2.0193
[Conv] 132
[Relu] 133                      0.99948 | 53.789    0.99959 | 47.679        0.99948 | 53.790    1.00000 | 3.2487
[Conv] 134
[Relu] 135                      0.99968 | 10.507    0.99989 | 6.3841        0.99968 | 10.587    1.00000 | 1.3482
[Conv] 136
[Relu] 137                      0.99929 | 38.506    0.99998 | 12.052        0.99930 | 38.632    1.00000 | 0.9736
[Conv] 138
[Relu] 139                      0.99883 | 71.367    0.99976 | 31.254
[Add] 140                       0.99904 | 75.123    0.99995 | 18.516        0.99908 | 73.733    0.99993 | 19.487
[Conv] 141
[Relu] 142                      0.99945 | 45.854    0.99983 | 26.760        0.99945 | 45.859    1.00000 | 2.1971
[Concat] 143                    0.99919 | 88.516    0.99996 | 21.293        0.99921 | 87.344    1.00000 | 0.0
[Conv] 144
[Relu] 145                      0.99842 | 70.084    0.99985 | 22.497        0.99846 | 69.236    1.00000 | 2.6179
[Conv] 146
[Relu] 147                      0.99858 | 42.952    0.99990 | 11.560        0.99862 | 42.444    1.00000 | 1.3279
[Conv] 148
[Relu] 149                      0.99964 | 13.247    0.99998 | 3.4466        0.99963 | 13.440    1.00000 | 0.5303
[Conv] 150
[Relu] 151                      0.99873 | 24.430    0.99990 | 6.7772        0.99865 | 25.100    1.00000 | 0.5249
[Conv] 152
[Relu] 153                      0.99811 | 21.922    0.99986 | 6.0111
[Add] 154                       0.99931 | 26.173    0.99997 | 5.8391        0.99930 | 26.481    0.99998 | 4.8893
[Conv] 155
[Relu] 156                      0.99788 | 25.428    0.99986 | 6.5101        0.99786 | 25.550    1.00000 | 0.4972
[Conv] 157
[Relu] 158                      0.99822 | 48.056    0.99989 | 11.806
[Add] 159                       0.99906 | 56.526    0.99993 | 15.512        0.99905 | 56.640    0.99993 | 15.646
[Conv] 160
# 省略....................................
[Conv] 278
[Relu] 279                      0.99433 | 49.585    0.99978 | 9.5895        0.99483 | 47.168    1.00000 | 1.0452
[Conv] 284
[Sigmoid] 285_int8              0.99878 | 1.9275    0.99995 | 0.4032
[exDataConvert] 285             0.99878 | 1.9275    0.99996 | 0.3611        0.99895 | 1.7816    1.00000 | 0.0857
[Conv] 282
[Sigmoid] 283_int8              0.99910 | 3.6657    1.00000 | 0.8721
[exDataConvert] 283             0.99910 | 3.6657    1.00000 | 0.7372        0.99915 | 3.5570    1.00000 | 0.1713
[Conv] 280
[Sigmoid] output_int8           0.99937 | 6.3836    0.99998 | 1.7267
[exDataConvert] output          0.99937 | 6.3836    1.00000 | 1.4713        0.99936 | 6.4075    1.00000 | 0.3804
I The error analysis results save to: ./snapshot/error_analysis.txt
W accuracy_analysis: The mapping of layer_name & file_name save to: ./snapshot/map_name_to_file.txt
done
精度分析接口如下,输出目录参数output_dir,是分析结果保存目录,默认值为’./snapshot’。
# Accuracy analysis
print('--> Accuracy analysis')
ret = rknn.accuracy_analysis(inputs=[IMG_PATH], output_dir='./snapshot', target='rk3588',device_id='192.168.103.150:5555')
if ret != 0:
    print('Accuracy analysis failed!')
    exit(ret)
print('done')
完整的精度分析包括模拟器精度分析(simulator_error)结果和板端精度分析(runtime_error)结果,同时都分为完整模型推理结果对比和逐层推理结果对比, 其中打印信息cos是余弦距离,值越接近1表示模拟器和板端运行结果越相识,euc是欧氏距离,值越小越相似,0 表示完全相同。
更多rknn-toolkit2的功能测试例程,参考下 toolkit2 functions , 更详细的说明请参考下 RKNN-Toolkit2工程文档 。
3.3. 板卡信息查看和设置
3.3.1. 对于rk356x(RK3566/RK3568)
鲁班猫板卡CPU默认是 interactive 状态,它会根据CPU使用率和目标负载来动态地调整CPU频率。
为获得更高运行速度或者性能评估,我们需要手动固定频率,参考下这:
1、CPU频率设置:
# 查看CPU当前频率
cat /sys/devices/system/cpu/cpu0/cpufreq/scaling_cur_freq

# 查看CPU当前调频策略
cat  /sys/devices/system/cpu/cpufreq/policy0/scaling_governor

# 查看可以设置的频率
cat /sys/devices/system/cpu/cpufreq/policy0/scaling_available_frequencies

# 设置允许root权限的用户通过sysfs的“scaling_setspeed字段将cpu频率设置成用户想要的频率
echo userspace > /sys/devices/system/cpu/cpufreq/policy0/scaling_governor

# 设置需要固定的频率
echo 1800000 > /sys/devices/system/cpu/cpufreq/policy0/scaling_setspeed
2、DDR频率设置:
# 查看DDR当前频率
cat /sys/class/devfreq/dmc/cur_freq

# 查看DDR当前调频策略
cat  /sys/class/devfreq/dmc/governor

# 查看DDR可以设置的频率
cat /sys/class/devfreq/dmc/available_frequencies

# 设置允许root权限的用户通过sysfs的“scaling_setspeed字段将cpu频率设置成用户想要的频率
echo userspace >  /sys/class/devfreq/dmc/governor

# 设置需要固定的频率,这里是1056000000
echo 1056000000 > /sys/class/devfreq/dmc/userspace/set_freq
3、NPU频率设置:
# 查看NPU查看可用的频率
cat /sys/class/devfreq/fde40000.npu/available_frequencies

echo userspace > /sys/class/devfreq/fde40000.npu/governor

# 设置频率
echo 900000000 > /sys/kernel/debug/clk/clk_scmi_npu/clk_rate

# 查看当前npu频率
cat /sys/class/devfreq/fde40000.npu/cur_freq

cat /sys/kernel/debug/clk/clk_summary | grep npu
3.3.2. 对于rk3588(rk3588s/rk3588)
1、NPU频率查询和设置
# 查看驱动版本
cat /sys/kernel/debug/rknpu/version

# 查看电源状态
cat /sys/kernel/debug/rknpu/power

# 查看NPU使用率,需要root权限
cat /sys/kernel/debug/rknpu/load

# 查看NPU可用的频率,然后设置频率
cat /sys/class/devfreq/fdab0000.npu/available_frequencies

echo userspace > /sys/class/devfreq/fdab0000.npu/governor

echo 1000000000 > /sys/class/devfreq/fdab0000.npu/userspace/set_freq

# 查看NPU当前工作频率
cat /sys/kernel/debug/rknpu/freq
3.3.3. NPU其他相关
# 查看librknnrt库版本
strings /usr/lib/librknnrt.so | grep "librknnrt version"

# 查看rknn_server版本
strings /usr/bin/rknn_server | grep build

# 查看NPU驱动版本
dmesg | grep -i rknpu

# 或者
sudo cat /sys/kernel/debug/rknpu/version
关于NPU驱动更新,鲁班猫板卡可以直接烧录网盘的最新镜像。